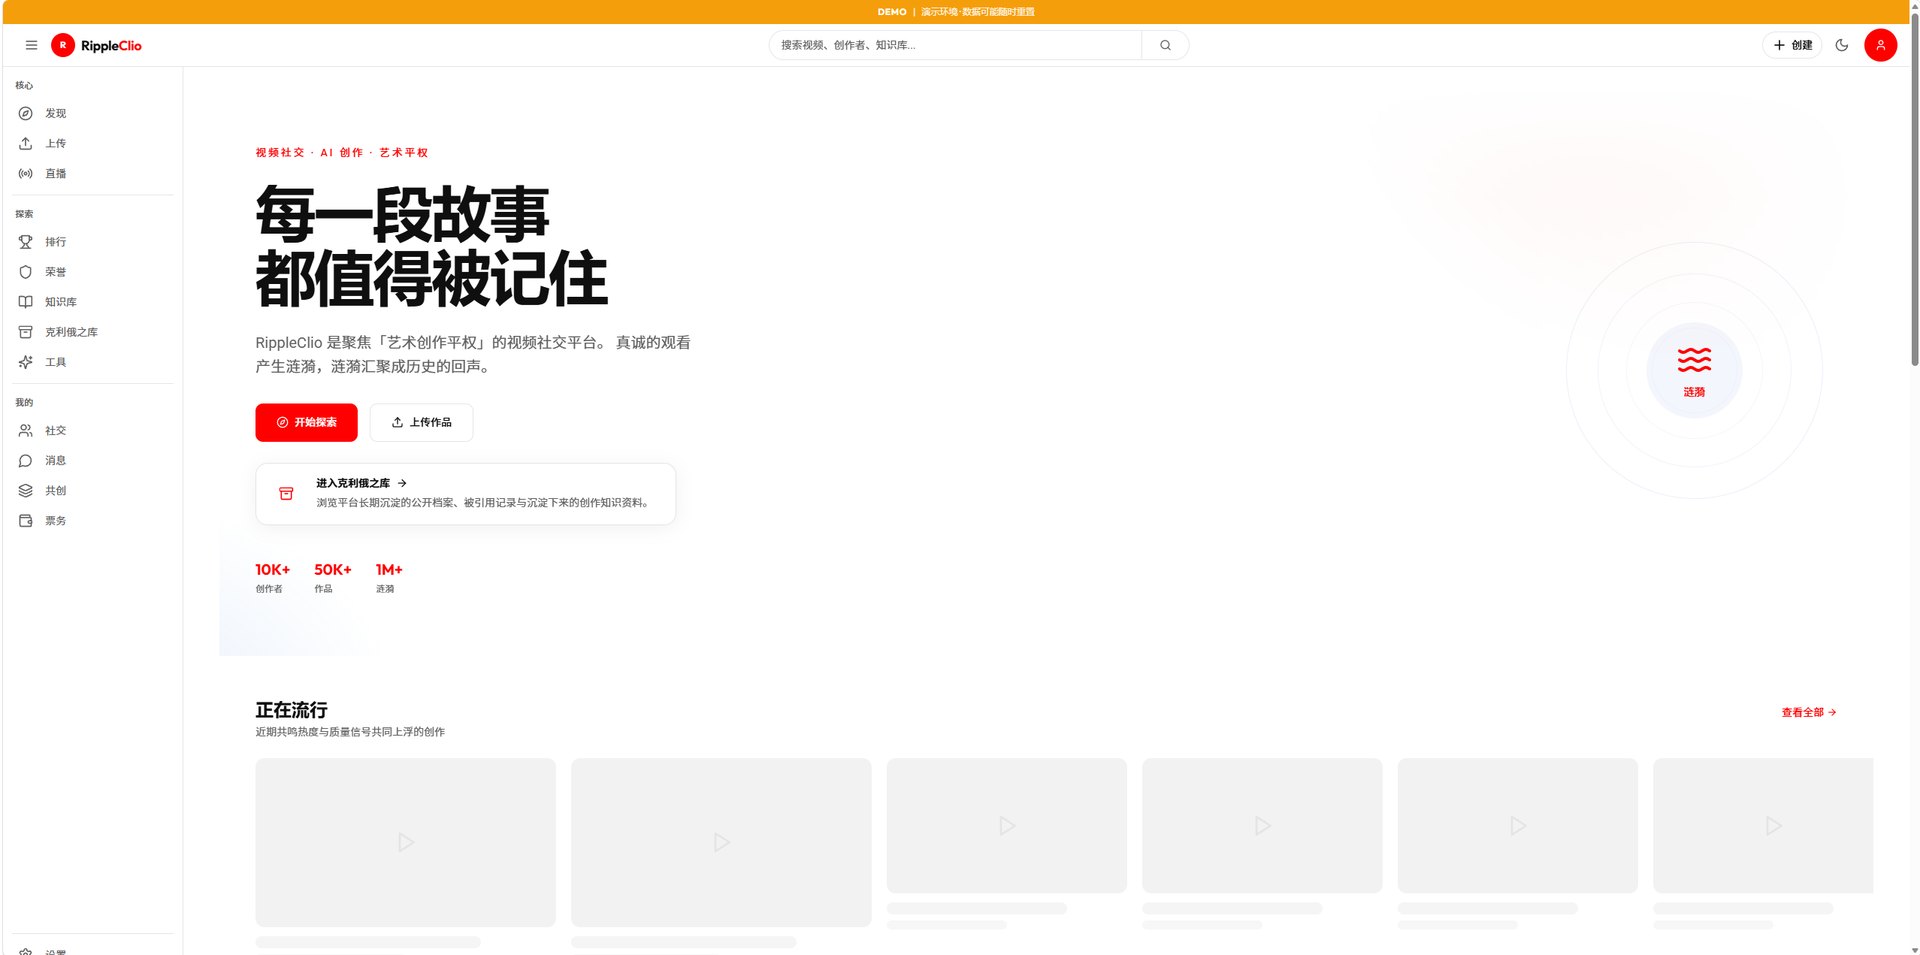
RippleClio 网站首页真实截图:视频社交 · AI 创作 · 艺术平台

At a glance

案例速览

要解决的问题
视频社交要在弱网下也能流畅播放;推荐、打标与知识库问答需要大模型能力,但用户数据(笔记、视频元信息、知识库)不能出内网,也不能承担外部 LLM 的持续调用成本。
约束条件
团队协作的 12 服务架构,需按团队规范对接 API Gateway 的路由与鉴权;推理只能用容器内的小模型(qwen2.5:3b),能力与时延都受限。
我的职责边界
在资深工程师指导下负责视频播放模块;参与本地模型部署调优、部分 Go 服务接口开发与联调、Docker / K8s 部署配置,以及部分前端数据可视化页面。
结果
弱网自动降码率、切换不黑屏,长 Feed 滚动不卡顿;在「数据不出网、无外部 LLM 成本」的前提下降低了推荐 / 问答时延。

Overview

项目说明

RippleClio 是 RippleClio × Wabifair 双轮生态的「精神家园」线——视频社交 + AI 创作,核心命题是「艺术创作平权」:让被传统流量分配机制忽视的创作维度(摄影 / 编剧 / 音乐 / 剪辑)各自被看见,把创作收益做成可量化、可结算、账目可追溯的机制。

平台架构(团队)

后端由 12 个 Go 微服务容器化并经 K8s 编排,所有流量经 API Gateway 统一路由与鉴权。推荐、内容打标与知识库问答全部走容器内 Ollama(qwen2.5:3b)本地推理 + pgvector 向量检索——推理就近、数据不出内网,不依赖任何外部 LLM API。前端分观众 / 创作者 web 与运营审核 admin-console 两端。

我的职责

  • 负责视频播放模块(资深工程师指导下):FFmpeg 多码率 HLS 转码,hls.js + MSE 自适应码率播放与分片预加载,Feed 虚拟化;
  • 参与本地 AI 模型的部署与调优:qwen2.5:3b 常驻预热、pgvector HNSW 检索、向量缓存与 RAG 分块检索;
  • 参与部分 Go 服务的接口开发与联调、Docker 多阶段镜像与 K8s 部署配置;
  • 负责部分前端页面与数据可视化(React + TypeScript + Recharts)。

它与 Wabifair · 文化美学跨境电商 共同构成双轮生态:两个平台通过共享的标签体系与金票机制联动。
Stack

技术栈与工具

  • FFmpeg · HLS(m3u8 + ts)
  • hls.js + MSE
  • TanStack Virtual / Query
  • React + TypeScript
  • Radix UI
  • Recharts
  • Ollama · qwen2.5:3b
  • pgvector · HNSW
  • RAG
  • PostgreSQL 16
  • Go 微服务 + API Gateway
  • Docker 多阶段构建
  • Kubernetes

Build

实现过程

按实现顺序拆开关键模块:每一步解决什么问题、为什么这样做。

  1. 平台背景(团队):12 个 Go 服务围绕「内容信用」展开

    video(上传 / 转码 / 播放 / Feed)、creation(团队协作 / 共创金库)、social、ticket(金票投票)、honor(荣誉 / 排行榜)、agora(涟漪 / 证言 / 礼赞三种表态)、knowledge(个人知识库)、recommendation、content-review、live、value-tag、worker。服务容器化后经 API Gateway 路由、K8s 编排。

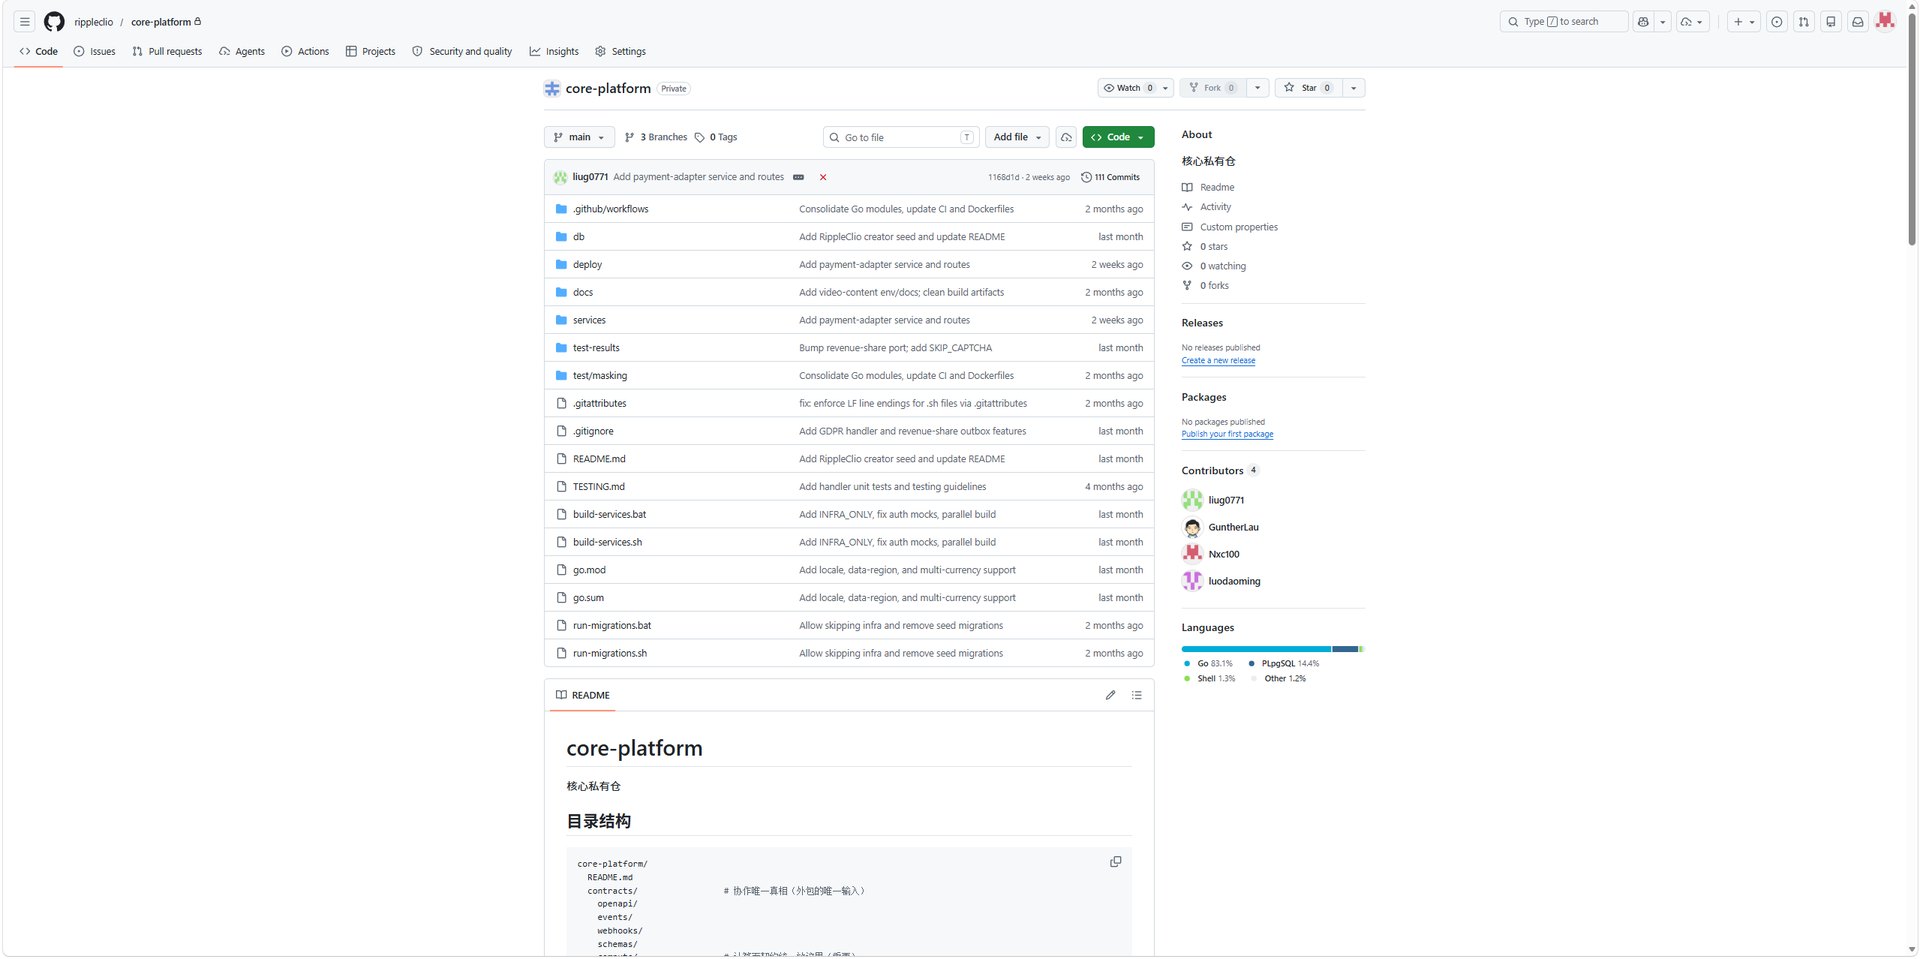
    团队私有仓库 core-platform 截图:多人协作的核心平台仓库
    团队私有仓库 core-platform 截图:多人协作的核心平台仓库
  2. 我负责的部分:多码率 HLS + 自适应码率播放

    用 FFmpeg 把上传视频转码为多个码率档位的 HLS(m3u8 播放列表 + ts 切片);前端基于 hls.js + Media Source Extensions 按实时网速在码率间切换(ABR),并做分片缓冲预加载——弱网自动降码率,切换过程不黑屏。

  3. 我负责的部分:Feed 虚拟化

    Feed 是无限滚动长列表,每项都带封面与播放器。用 TanStack react-virtual 只渲染可视区域内的条目,DOM 数量保持恒定,长列表滚动不卡顿;配合 TanStack Query 做请求缓存与分页。

  4. 参与:本地大模型部署与向量检索调优

    量化后的 qwen2.5:3b 在容器内常驻推理并预热,避免冷启动;pgvector 建 HNSW 索引做近似最近邻(ANN)检索,用 embeddingKey / cacheKey 缓存向量避免重复计算,配合 RAG 分块检索,在不出网、零外部 LLM 成本的前提下降低推荐与问答时延。

  5. 参与:服务联调与部署配置

    按团队规范对接 API Gateway 的路由与鉴权,参与部分 Go 服务的接口开发与联调;协助完成 Docker 多阶段镜像构建与 K8s 部署配置——Deployment、readiness / liveness 探针与扩缩容。

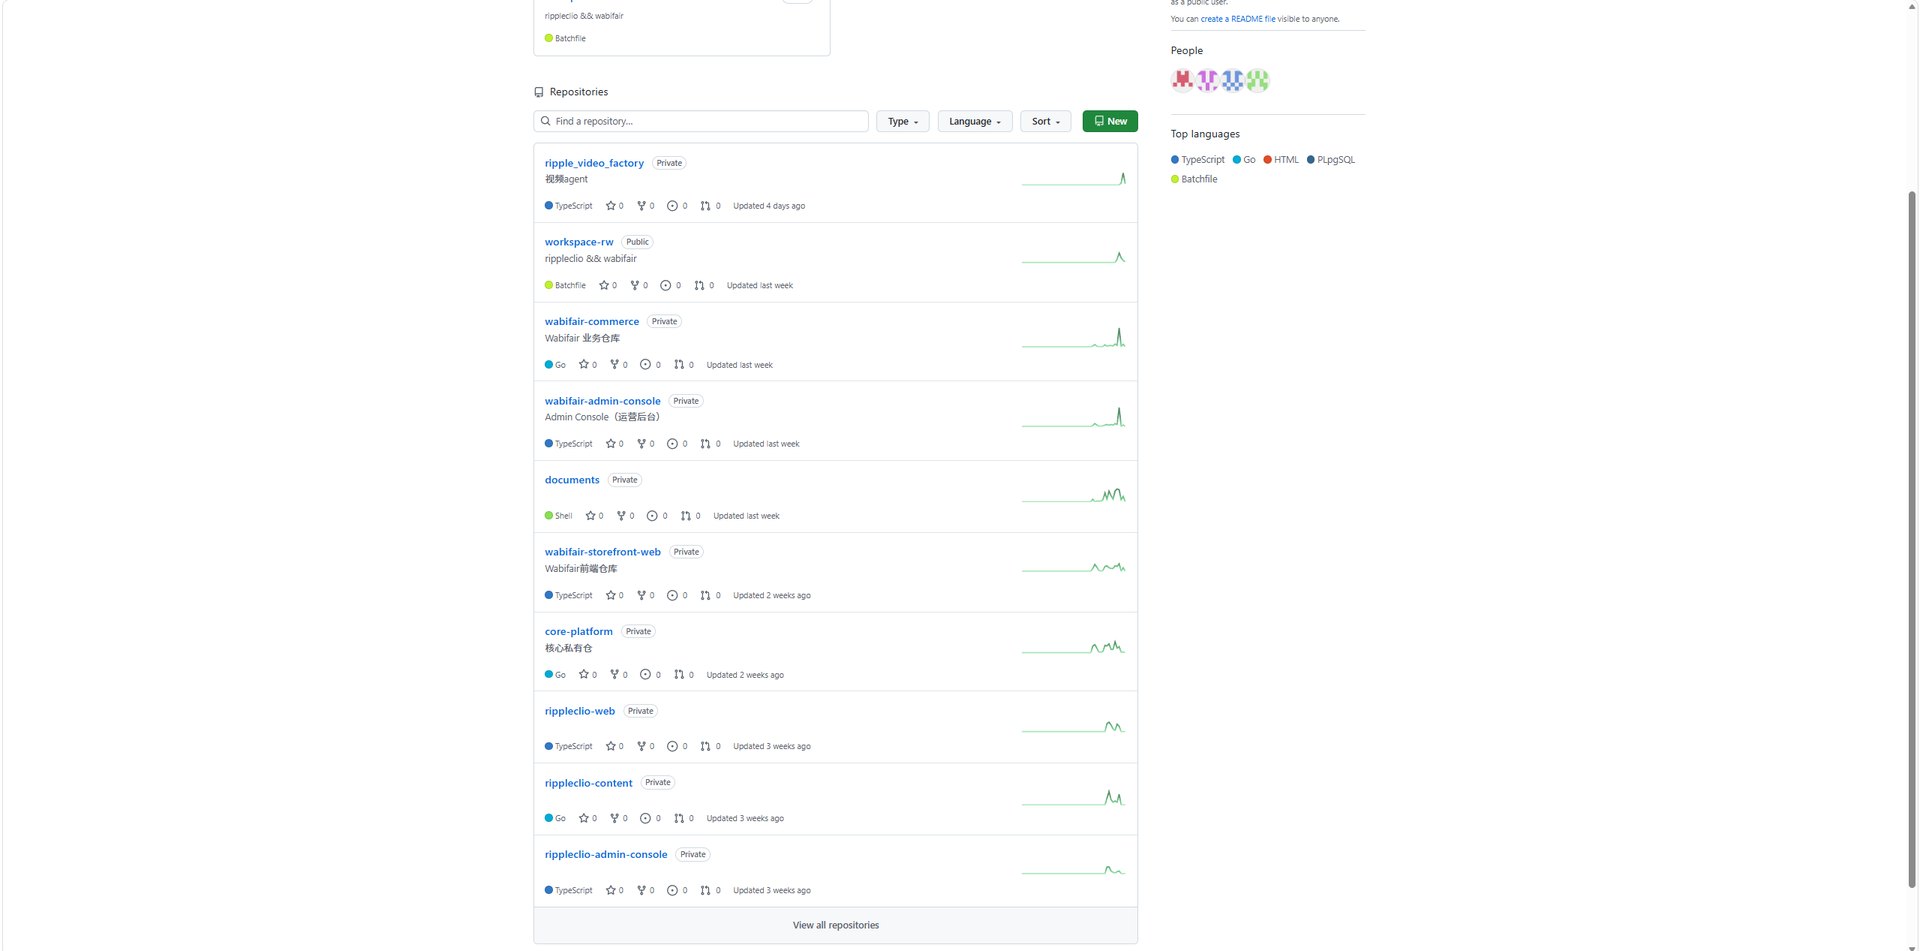
    团队 GitHub 组织仓库列表截图:rippleclio-web / rippleclio-content / core-platform 等
    团队 GitHub 组织仓库列表截图:rippleclio-web / rippleclio-content / core-platform 等

Decisions

关键决策

说明为什么这样做,而不只是列出做了哪些动作。

Q1

推理就近、不出网是「结构性」选择

完全可以接外部大模型 API,但那意味着用户的笔记、视频元信息、知识库都要经过第三方。选择容器内 Ollama:能力更弱、延迟更高,但数据不出网——对「个人知识库 + 内容信用」来说,这是结构性选择,不是性能选择。所以调优重点放在预热、缓存与索引上。

Q2

pgvector 是 MVP 阶段最省运维的向量方案

PostgreSQL 已经是主库,pgvector 让向量和业务表在同一事务里读写,推荐、知识库、打标三个场景的查询都走 SQL。HNSW 相比 IVFFlat 在速度与召回之间的权衡更好,代价是建索引更慢、占内存更多——在数据量不大的阶段可以接受。

Q3

自适应码率解决的是「最差网络」的体验

视频社交的留存取决于最差那一刻:弱网卡住的首帧。多码率 + ABR 让播放器按网速选档位,比一味追求高码率更重要;分片预加载则把切换卡顿藏在缓冲里。

Result

交付与结果

交付内容

  • 视频播放模块:FFmpeg 转码多码率 HLS(m3u8 + ts 切片),前端 hls.js + MSE 实现自适应码率(ABR)播放与分片缓冲预加载
  • Feed 长列表虚拟化(TanStack react-virtual),长列表滚动不卡顿
  • 本地推理调优:量化 qwen2.5:3b 容器内常驻并预热避免冷启动;pgvector 建 HNSW 索引做近似最近邻检索,embeddingKey / cacheKey 缓存向量避免重复计算,配合 RAG 分块检索
  • 部分 Go 服务的接口开发与联调,协助 Docker 多阶段镜像构建与 K8s 部署配置(Deployment、readiness / liveness 探针、扩缩容)
  • React + TypeScript + Recharts 页面:推荐结果与统计图表展示

项目结果

  • 弱网下自动降码率、码率切换不黑屏;长 Feed 滚动不卡顿
  • 推理就近、不出网:推荐 / 标签 / 知识库问答不依赖任何外部 LLM API
  • 向量缓存 + HNSW 索引让检索在小模型条件下仍保持可用的时延

Retrospective

复盘

这是一个多人协作的大型项目,我学到最多的是在别人定好的架构里做好自己那一块:先读懂网关、鉴权与部署规范,再动手写播放和检索相关的代码。团队项目的成果属于团队,这里只列出我负责和参与的部分。

References

方法与参考

本案例用到的工程模式与模型能力,附权威出处,方便核对。