30+ 可复跑的工作流 JSON
12 GB 消费级显存(RTX 5070)本地运行
6 个 主题:出图 / 分镜 / 姿态 / 参考 / 抠图 / I2V
20+ 页 节点级说明文档,含批量与 API 方案
- 要解决的问题
- 电商与短视频需要大量风格一致、可控的图像与视频素材;云端 GPU 成本高、可用率不稳定,单个上游模型也做不到面面俱到。
- 约束条件
- 只有一张 12GB 显存的消费级显卡;人物身份在换姿势、换动作、生视频之后必须保持一致;工作流要能交给团队复用,而不是只有作者能跑。
- 我的职责边界
- 独立完成工作流设计、节点编排、量化与显存调参、批量脚本与说明文档。
- 结果
- 「静帧 → 视频 → 抠图」三个能力沿同一张参考图走完;全部主力工作流可在 12GB 本地运行,并沉淀为团队可复用的工作流库。
这不是一个工作流,而是一份 30+ 个 ComfyUI 工作流组成的工作流库:跨 6 个主题、5 个上游模型生态、多次迭代沉淀下来,全部运行在一张 RTX 5070(12GB 显存) 上。
六个主题
- 基线出图:zImageTurboBase v60 下 GGUF / bf16 双轨,同 LoRA 堆同 prompt 对照「质量 vs 显存」;
- 单张分镜 + ColorMatch:把「分镜逻辑」与「色调家族」拆开,换品牌场景只改 ColorMatch;
- 姿态迁移:从 v1 clean 到 Qwen-Image-Edit-2511 AnyPose V4 FaceID,全代并存;
- Kontext 多图参考:FLUX Kontext + Nunchaku INT4,定位「出货快」;
- 抠图换背景:SAM2 点击式极简抠图 + ComfyUI-RMBG 批量抠图;
- LTX-2.3 首尾帧带音频生视频:首尾帧注入 + 音视频联合生成 + GGUF 12GB 版。
同一张参考图,走完静帧 → 视频 → 抠图
Hero shot 被设计成跨工作流复用的「身份锚点」:LoRA 堆在工作流之间不重复叠加,颜色、饱和度与背景质感在不同工作流里都能被识别为同一个主体。这套库真正的交付物,是一份沿同一审美约束、跨多模型、可以并排对照的判断库。
配图说明:封面与主视觉是 zImageTurboBase v60 在 bf16 模型上的基线出图;步骤中穿插了姿态迁移成品与 LTX-2.3 起始帧,均为本工作流库的真实输出。
- ComfyUI(节点编排 + API 脚本化)
- ComfyUI-GGUF
- Nunchaku(SVDQuant 4-bit)
- Qwen-Image-Edit-2511 + Lightning
- FLUX Kontext
- ControlNet OpenPose + 3D 姿态编辑器
- LTX-2.3(FLF2V + 音视频联合生成)
- SAM2
- ComfyUI-RMBG(RMBG-2.0 / BiRefNet)
- ReActor · LoRA · ColorMatch
Process
制作流程
不只展示结果,也展示每一步的判断与取舍是如何形成的。
-
01
基线出图:zImageTurboBase v60 GGUF / bf16 双轨
四份基线工作流共用同一套 LoRA 堆与 Lightning 调参:bf16 版走原生模型,GGUF 版走 12GB 量化。两轨并存,是为了让同一 prompt 在两份模型上对照「质量 vs 显存」——试机期求快,交付期求稳。这一步产出的定点参考图,是后续姿态迁移、Kontext 与 I2V 的共同起点。
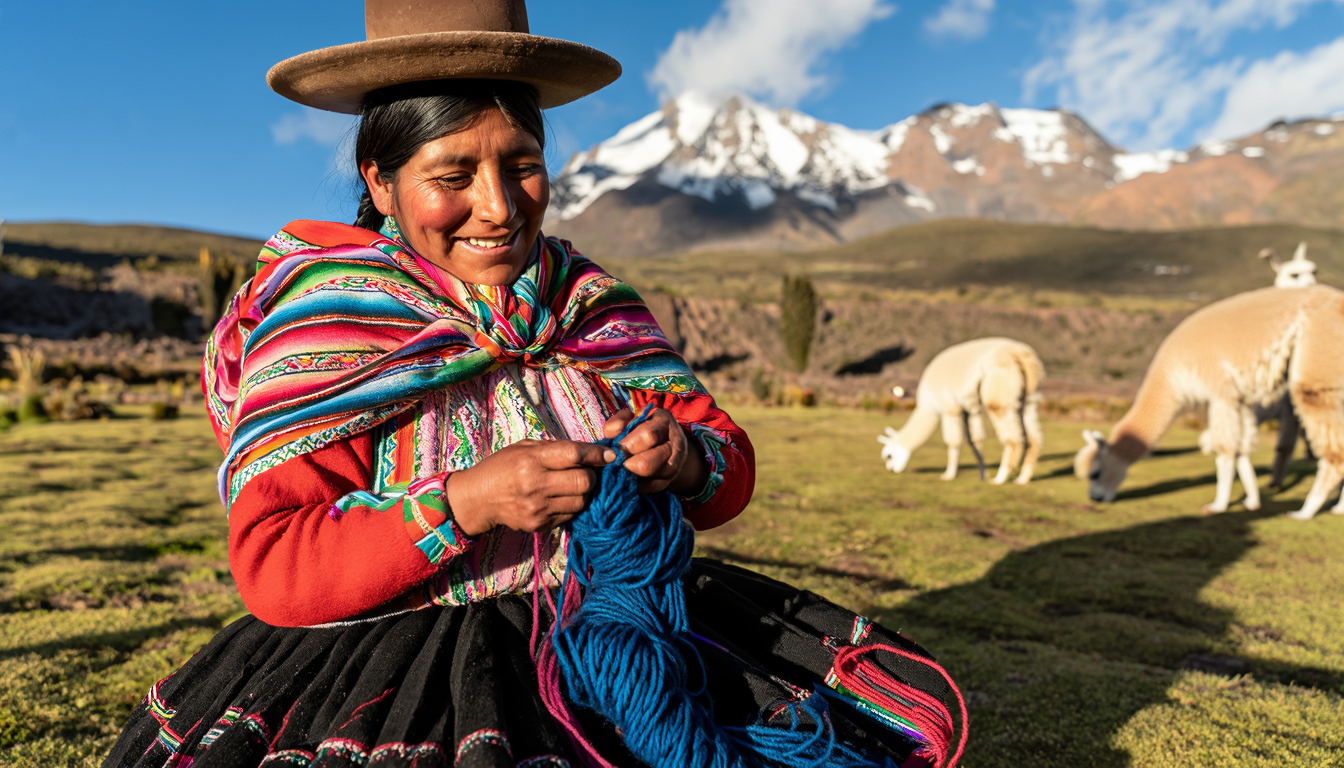 zImageTurboBase v60 在 bf16 模型上的基线出图样本
-
02
单张分镜 + ColorMatch 后处理
单张分镜工作流从一张起点图 + 一段 prompt 出多个分镜候选;ColorMatch 版本再把多张分镜拉回同一个色温家族。「分镜是内容,色调是品牌」这个拆分,让换品牌场景时只需改 ColorMatch 参数,不动分镜逻辑。
-
03
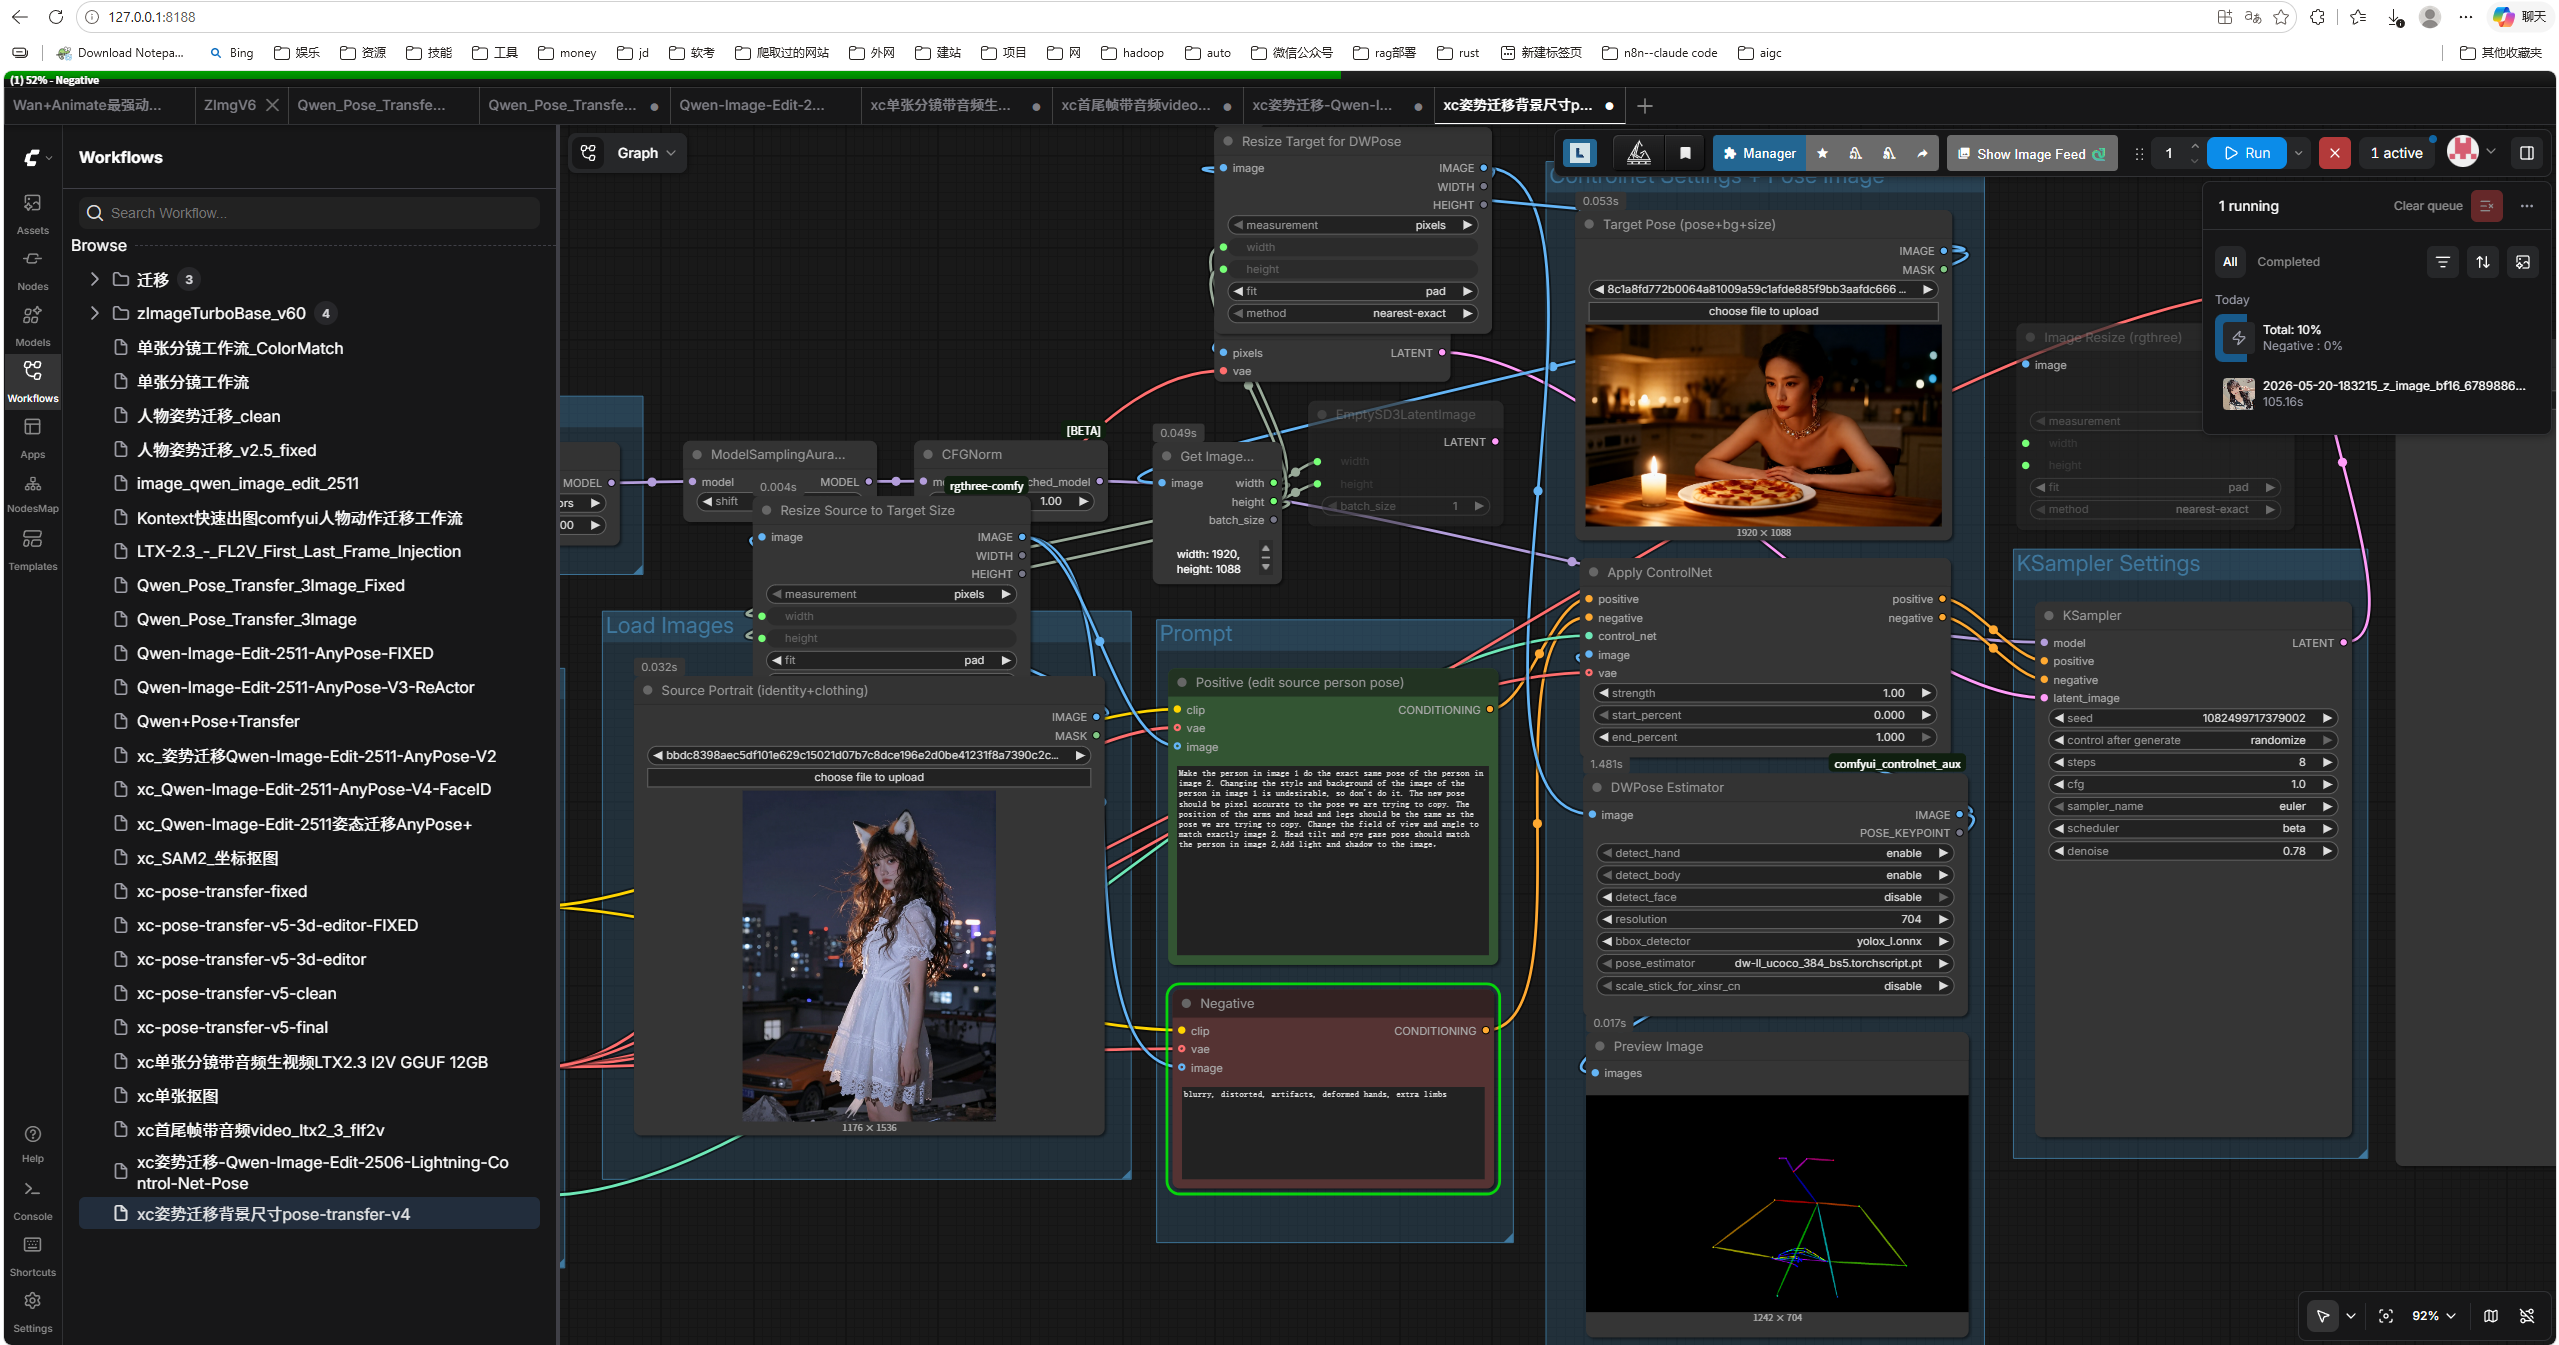
姿态迁移:从 v1 clean 到 V4 FaceID
早期 xc-pose-transfer 经 v2.5(修节点连接 bug)→ v4(修背景尺寸错位)→ v5(加 OpenPose 3D 编辑器;FIXED 版修模型升级后的 LoRA 适配)。Qwen-Image-Edit-2511 表现出对指定姿势的可控性后,转到 AnyPose V2(33 节点)→ V3 ReActor(加换脸)→ V4 FaceID(加 CFGNorm + 多 LoRA 堆),「参考图 + pose 图 + 文本」三路输入联合控制。每一代都保留,方便对照。
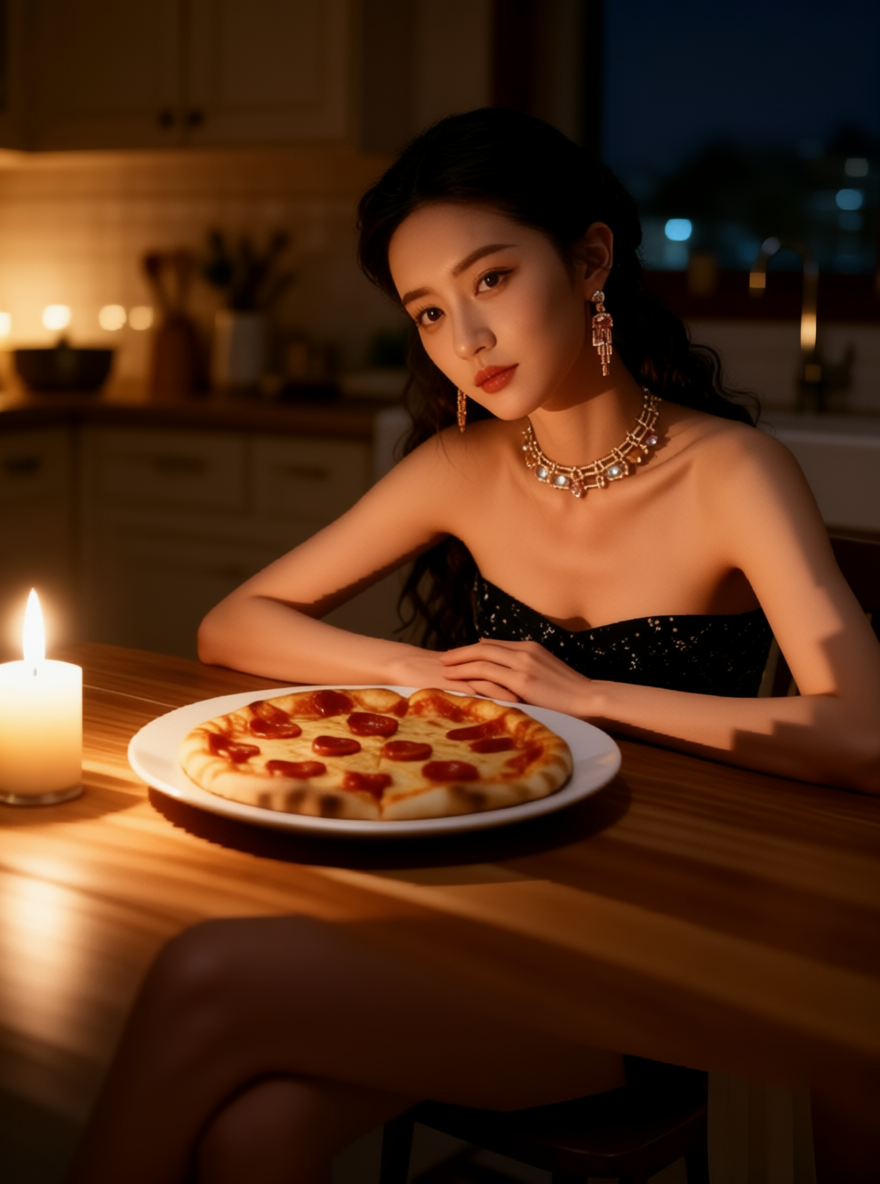 Qwen-Image-Edit-2511 AnyPose 姿态迁移成品:参考图 + pose 联合控制
-
04
Kontext 多图参考:出货快的另一条路线
FLUX Kontext + Nunchaku INT4 加速 + StyleModel + CLIPVision + 多图拼接 + 3 个串联 KSampler(60 节点)。定位是「快速出图」:Qwen AnyPose 路线求身份准,Kontext 路线求出货快,二者互补。
-
05
抠图与换背景:SAM2 + RMBG 双管线
SAM2 坐标抠图只有 9 个节点:加载图像 → 加载 SAM2 → 按坐标点分割 → 遮罩转图 / 反相 → 合成 Alpha → 保存,抠图从「调参数、画遮罩」变成「这里点一下」。批量场景走 ComfyUI-RMBG(RMBG-2.0 / BiRefNet / BiRefNetUltraV2),按电商、人像、发丝场景分别调参,输出透明 PNG 直接进入换背景与视频广告流程。
-
06
LTX-2.3 首尾帧带音频生视频
套件里最复杂的一套:两处首尾帧注入、两处音视频 latent 拼接、音频 VAE 解码与空音频 latent、两组自定义采样器,最后合成视频。UnetLoaderGGUF / DualCLIPLoaderGGUF 量化让它在 12GB 显存上可跑,单张分镜即可产出带音频的短视频。
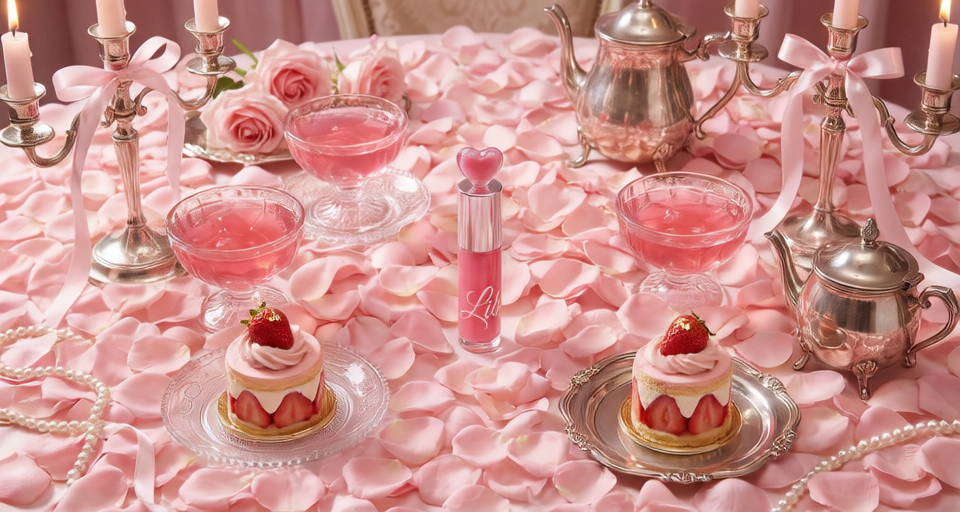 LTX-2.3 图生视频起始帧样本:单张分镜驱动带音频视频
Thinking
创作思路
说明为什么这样做,而不只是列出做了哪些动作。
Q1 工作流不是工具,是「被保存下来的判断」
节点图最重要的价值不是「能跑起来」,而是把决策留存下来:为什么这个节点在这里、为什么 LoRA 是这个顺序、为什么 CFG 必须归一化——都是用参数表达的审美判断。JSON 一旦存盘,判断就不会随口头描述变模糊。
Q2 多代并存,才能说清为什么升级
姿态迁移每一代都保留,不覆盖、不删除。只有并存才能对照,只有对照才能说清「为什么 V4 要加 FaceID + CFGNorm」;「二选一升级」会丢掉迭代的设计动机。
Q3 12GB 显存是设计约束,不是忍受约束
所有主力工作流都提供 GGUF 版本;Wan Animate 用 BlockSwap 让大模型分块加载;Kontext 用 Nunchaku INT4 加速;LTX I2V 明确标注「12GB」。「这套能不能跑」从「赌云 GPU 可用率」变成「本地几分钟出一张」。
Q4 许可证也是选型的一部分
RMBG-2.0 的权重仅限非商业使用,BiRefNet 为 MIT 许可。商用交付的素材应走 BiRefNet 管线或取得商业授权——把许可证写进工作流说明,和写清参数一样重要。
Q5 保留 clean / fixed 双版本是工程现实主义
clean 是最纯净的最小可跑版,fixed 是被真实 bug 教训过、加了防坑节点的生产版。看 clean 理解结构,看 fixed 理解「为什么加这些」——就像代码与注释并存。
交付内容
- 30+ 个可复跑的 ComfyUI 工作流 JSON,按主题分档(姿态迁移 / I2V / Kontext / 抠图 / 基线出图 / 分镜)
- 姿态迁移多代迭代:从
人物姿势迁移_clean.json 到 v5 FIXED,并迁移到 Qwen-Image-Edit-2511 AnyPose V2 → V3 ReActor → V4 FaceID - LTX-2.3 首尾帧注入的图生视频工作流:音视频联合生成 + 潜空间上采样,GGUF 量化压进 12GB
- 抠图管线:SAM2 坐标点击式极简抠图(9 节点)+ ComfyUI-RMBG 单张 / 批量抠图,双管线热切换,输出透明 PNG 接入换背景与广告流程
- 20+ 页节点级说明文档(含批量方案与 ComfyUI API 脚本)
项目结果
- 「静帧 → 视频 → 抠图」沿同一张参考图走完,不用在工具间反复倒手
- GGUF 量化 + Nunchaku 加速 + 分辨率 / 分块解码调参,所有主力工作流在 12GB 显存上可跑,不依赖云端 GPU
- 姿态迁移从「随机脸」升级到「实人脸 + 身体姿势可控」
- 不绑定单一上游:Qwen / FLUX Kontext / LTX / Wan / SAM2 各取所长,跨生态保持审美一致
这套工作流库最有用的部分,其实是那 20 多页说明文档:工作流只有被别人跑通,才算真正交付。节点图记录「怎么做」,文档记录「为什么这样做」和「坑在哪里」。
References
方法与参考
本案例用到的工程模式与模型能力,附权威出处,方便核对。